小澤 仁(おざわ・ひとし)
バンコック銀行執行副頭取。1977年東海銀行入行。2003年より現職。米国在住10年。バンコク在住27年。趣味:クラシック歌唱、サックス・フルート演奏。
前回の拙稿第329回「複雑な脳の仕組みを模倣し単純化―大きく進化した生成AI(上)」(10月23日付)では、生成AI(人工知能)が「物や言語などあらゆる客体を要素に分けて記憶する手法」を習得して大きく進化したことを説明した。例えば「リンゴ」であれば甘い、酸っぱい、おいしい、丸い、固い、赤い、緑色、5-10センチの大きさ、ほのかに匂う、などの様々な要素を数値に置き換えて生成AIのデータベースに蓄積する。そして実際のリンゴを見たときに過去の記憶したデータを総合してリンゴであることを認識するのである。
その分散型の記憶方法を担うのがAIの「ニューラルネットワーク」(人間の神経細胞〈ニューロン〉の働きを数学的に模倣〈もほう〉した機械学習手法)である。では、どのように総合的に判断をするのだろうか。その役割を担うのがベクトルや行列計算などの数学の手法である。今回も宮城県の七十七銀行からバンコック銀行日系企業部に出向している福島将太(しょうた)さんがまとめた生成AIに関するレポートを引用しながら、生成AIの進化の流れを振り返ってみたい。
1. ベクトル手法の応用
世界の実態を知覚・分析する手法として発展してきたのが「哲学」と「数学」である。現代科学において数学は分析や予測を行う上での基本的なツールを用意してくれる。生成AIを理解する上ではベクトルと行列計算が大きな役割を果たす。
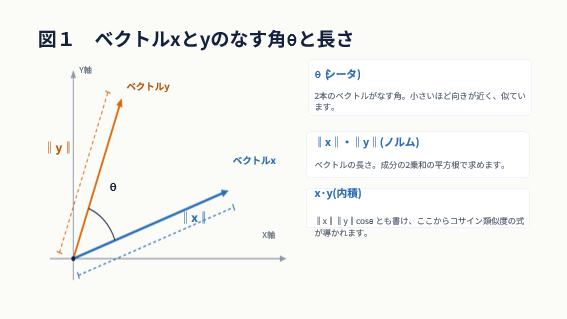
ベクトルとは「大きさ」と「向き」の両方を持つ量を指す。生成AIではリンゴを認識するときに甘い、酸っぱい、丸い、固い、赤いなどの要素を分解して記憶するがこれらを数値化するのである。甘さを等級化してその甘さを100、80、50などとして記憶する。またリンゴの甘さが持つ重要度を等級化して認識する。これらの特徴と重要度をかけ合わせるとベクトルとして数値化される。
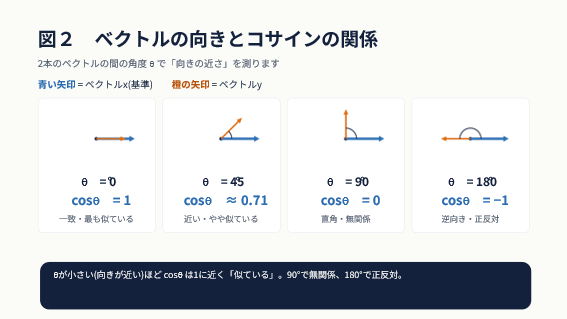
ある特定の対象を「リンゴ」という認識するためには、その対象のベクトルが多数の「リンゴ」のベクトルの平均値に近ければ「リンゴ」と判断される。その近似値判断に使われるのが、ベクトル間の向きを表すコサインである。
この関係を生成AIのノードシステムとして取り入れたものが以下の図3である。
[図3 ノードの構造]
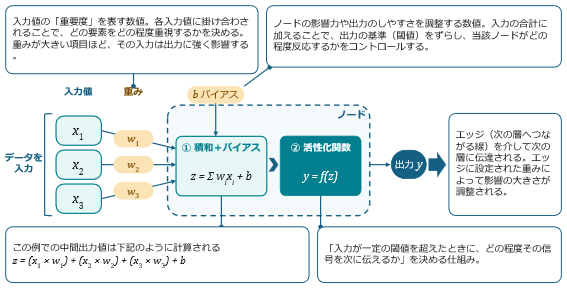
繰り返しになるが、リンゴの各要素をX1からXnまでに数値化して記憶し、その重要度をW1 からWnまでに入力してベクトル値を計算する。それを下図4の計算式で近似値判断するのである。
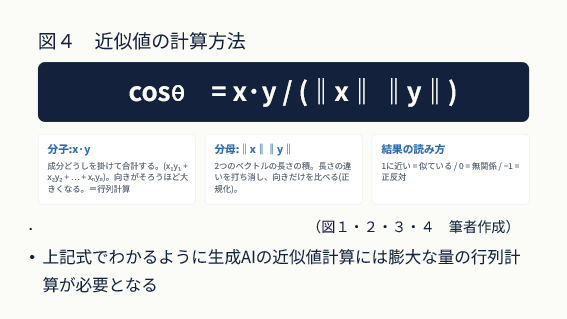 2. 学習プロセス(順伝播・逆伝播・最適化)
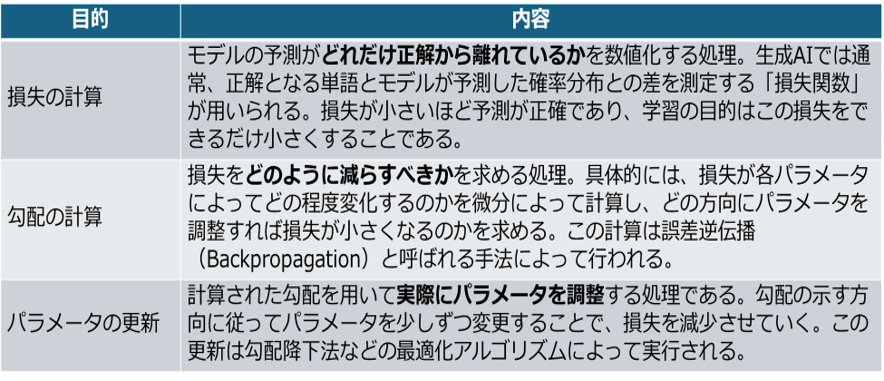
①生成AIの学習とは、モデル内部のパラメータ(重み・バイアス)を調整し、正しい出力を出せる状態に近づける過程。順伝播(でんぱ)・損失計算・逆伝播・最適化の四段階から成り、この一連のサイクルを膨大な回数繰り返すことでモデルは精度を向上させる。
②順伝播では、入力データをモデルに与え現在のパラメータに基づく予測結果を計算する。
③損失計算では、予測結果と正解データとの差(損失)を数値化する。値が大きいほど予測が不正確であることを意味する。
④逆伝播では、損失がどのパラメータによって生じたかを計算し、各パラメータの修正量(勾配〈こうばい〉)を求める。
⑤最適化では、勾配に基づきパラメータをわずかに調整し、損失が小さくなる方向へ更新する。
⑥この一連の処理は、正解に近づくまで何百万回、何十億回と反復される。生成AIの学習に膨大な計算資源が必要とされる理由は、この反復処理にある。
【表1:損失計算・勾配計算・パラメータ更新の概要】
出典:AIに関する各種ウェブサイトを参考に筆者作成
3. 生成AIに適したロジック集積回路であるGPU
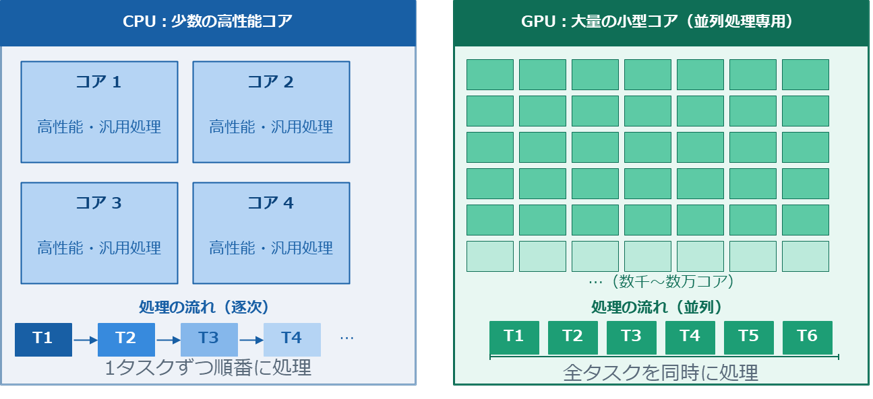
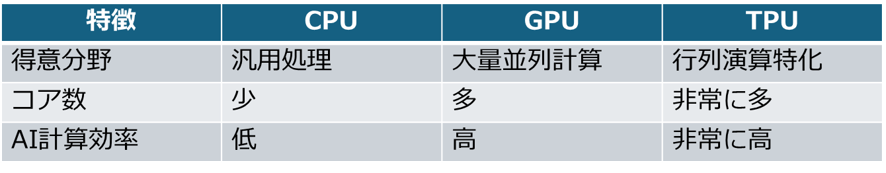
①生成AIの学習・推論では膨大な行列演算が連続的に発生する。CPU(中央演算処理装置)が逐次処理に最適化された汎用(はんよう)チップであるのに対し、GPU(画像処理装置)は大量の演算を同時に処理する並列処理に特化しており、AIの大規模行列演算に適している。
②GPUはもともと画像処理用に開発されたチップだが、AIの内部で発生する行列演算も同様の並列処理であるため、AI開発の標準となっている。現在、AI向けGPU市場ではNVIDIAが約8割のシェアを占めている。
【CPUとGPU】
出典:AIに関する各種ウェブサイトを参考に筆者作成
注:NVIDIAのGPUの構造については、拙稿第275回「世界最先端の半導体会社NVIDIAの技術の強み(その1)」(2024年9月20日付)と第276回「世界最先端の半導体会社NVIDIAの技術の強み(その2)」(24年10月4日付)をご参照ください。
4. 計算速度を上げる工夫―TPU(Tensor Processing Unit)
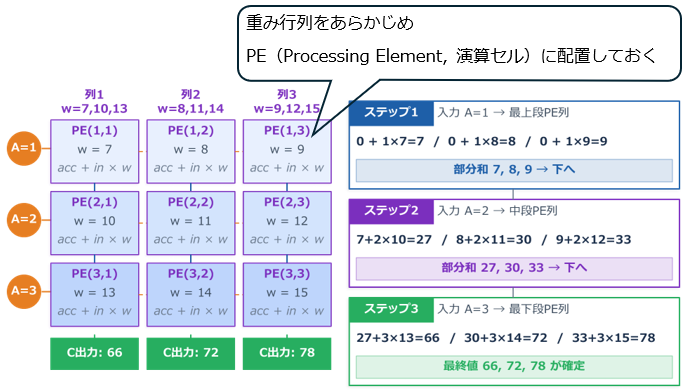
①TPU(Tensor Processing Unit)はGoogleがAI処理に特化して内製開発した専用チップ。GPUが計算のたびにメモリからデータを読み出すのに対し、TPUは重みデータをあらかじめチップ内部に配置し、入力データを順に流し込む構造を採用している。例えばリンゴを記憶する場合、各要素の重要度は毎回変化するわけではない。このような重みのデータについてあらかじめ入力しておくのである。
②この構造により重みのデータの入力作業が省いて計算を進めることができ、高速かつ省電力な処理を実現している。
③AIの演算では数値を何ビットで表現するかによって、精度と処理速度がトレードオフの関係にある。学習では精度の高い32ビット(FP32)が標準だが、推論時などは16ビット(FP16)や8ビット(INT8)に落とすことでメモリ消費を抑え処理速度を上げることができる。GPUは複数のビット数に対応した専用回路を持ち、TPUは16ビット演算に特化(GPUよりも精度の低い規格に対応)することでさらなる効率化を図っている。
【CPU、GPU、TPUの比較】
出典:AIに関する各種ウェブサイトを参考に筆者作成
▶TPU【TPUの行列計算の流れ】
出典:AIに関する各種ウェブサイトを参考に筆者作成
5. Anthropicの試み
5.1 主力製品Claudeと技術的特徴
①Claudeは大規模言語モデル(LLM)であり、学習手法も他の主要LLMと同様の基盤から始まる。まず事前学習として膨大なテキストデータから言語の構造・知識・推論パターンを獲得し、続いて人間を介した強化学習(RLHF)によって有用・安全・誠実な応答を優先するよう調整される。この二段階はOpenAIのGPTシリーズやGoogleのGeminiでも採用されている標準的な手法である。
②2026年4月、AnthropicはClaude Mythosという新たなモデルを発表。Mythosは特にサイバーセキュリティー分野において極めて高い能力を持つとされており、SWE-bench Verified(ソフトウェアエンジニアリング評価)で93.9%、数学評価USAMO 2026では97.6%を記録し他社のAIの評価を凌駕(りょうが)した。サイバーセキュリティー分野では、エキスパートレベルのCTF問題※において73%の解決率を達成している。
※CTF(Capture The Flag):システムの脆弱(ぜいじゃく)性を突いて隠された文字列(フラグ)を奪取するサイバーセキュリティーの実践的な技術競技。
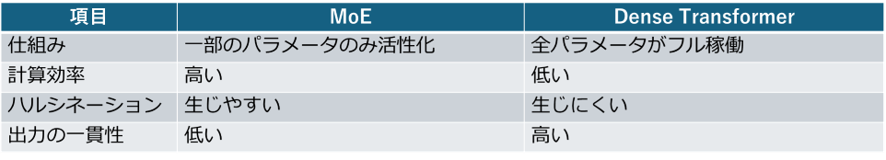
③これほど性能の高いClaudeのアーキテクチャー(製品の設計構造)であるが、Anthropicは詳細な技術情報を公式に開示していない。外部の技術分析では、GPT-4oやGeminiが採用する「Mixture of Experts(MoE:入力ごとに一部のパラメータのみを活性化する方式)」とは異なり、Claudeはすべてのパラメータが常にフル稼働する「dense transformer」を採用していると推測されている。MoEは計算効率や計算速度に優れるが、ハルシネーション(誤情報生成)がたびたび生じる。一方、Claudeが採用するdense transformerは効率性を犠牲にしているが、出力の一貫性・整合性の面で有利とされる。特にコーディングや数学的推論のように正確性が求められる分野では、dense transformerの優位性が発揮されると考えられている。ただしAnthropicはこうした外部の推測に対してコメントしていない。
【MoEとDense Transformer】
出典:AIに関する各種ウェブサイトを参考に筆者作成
5.2 安全設計:Constitutional (憲法)AI
①Constitutional AIは、Anthropicが2022年に発表した独自の安全学習手法である。
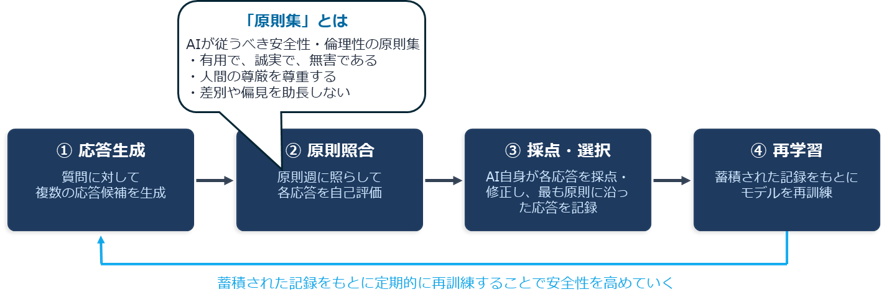
前項で述べた通り、Anthropicは効率性よりも正確性を重視してdense transformerのアーキテクチャーを採用した。これにより生成AIの能力が飛躍的に高まり、生成AIの暴走の可能性が現実のものとなってきた。このため「人間の尊厳を尊重する」「差別や偏見を助長しない」「有用・誠実・無害である」といったAIが従うべき安全性・倫理性の原則を定めたのである。特徴的なのは、単なる禁止事項の列挙ではなく、AIが未知の状況に直面した場合でも、原則に基づいて判断できるよう設計されている点にある。
②学習プロセスは次のように進む。まずモデルが質問に対して複数の応答候補を生成する。次にモデル自身が、「この応答は原則集の内容に違反していないか」という観点から各応答を評価・比較する。そして、より原則に沿っていると判断された応答が「望ましい応答」として記録される。このデータを用いてモデルを再学習することで、原則に沿った応答を自然に生成できるよう誘導していく。これにより、人間がすべての応答を個別に確認・評価する負担を大幅に削減できる。
【Constitutional AIの学習サイクル】
出典:Anthropic「Constitutional AI: Harmlessness from AI Feedback」(2022)をもとに筆者作成
6. あとがき
今回は数学を活用した生成AIの仕組みについて見てきた。ベクトルの概念を使った近似値の計算と推論を行うための学習プロセスで膨大な量の行列計算が必要となる。このために膨大な量の行列計算に特化したGPU、さらにTPUが開発されてきた。これらは小さな気づきで生まれたものである。また全く逆の発想で正確性を追求したAnthropicのアーキテクチャーも大きな進化を生み出している。「技術革新」はこうした小さな気づきによって遂行されているようである。(以下、次回に続く)
※『バンカーの目のつけどころ 気のつけどころ』過去の関連記事は以下の通り
第329回「複雑な脳の仕組みを模倣し単純化―大きく進化した生成AI(上)」(2026年10月23日付)
https://www.newsyataimura.com/ozawa-210/#more-23727
第276回「世界最先端の半導体会社NVIDIAの技術の強み(その2)」(2024年10月4日付)
https://www.newsyataimura.com/ozawa-157/#more-18361
第275回「世界最先端の半導体会社NVIDIAの技術の強み(その1)」(2024年9月20日付)
https://www.newsyataimura.com/ozawa-156/#more-15198



コメントを残す